
🗓️ अंतिम अपडेट: 19 अक्टूबर 2026 | ✍️ केवल कृष्ण घोड़ेला | UGC NET Paper 1, इकाई 7
आँकड़ा निर्वचन (Data Interpretation, DI) UGC NET Paper 1 की इकाई 7 है। इसमें प्रायः एक तालिका या ग्राफ़ दिया जाता है और उस पर प्रतिशत, अनुपात, औसत और वृद्धि के प्रश्न पूछे जाते हैं। साथ में आँकड़ों के स्रोत, आलेखों के प्रकार और आँकड़े-और-शासन से भी प्रश्न बनते हैं। इस लेख में UGC NET Data Interpretation Notes in Hindi तालिकाओं और हल किए हुए चार डेटा-सेट के साथ हैं, और परीक्षा पैटर्न वाले 16 MCQ भी (डेटा-सेट पर आधारित प्रश्न, बहु-कथन, कथन-कारण, सुमेलित और क्रम वाले प्रश्नों सहित)।
⚡ संक्षिप्त उत्तर
- इकाई: UGC NET Paper 1 की इकाई 7: आँकड़ा निर्वचन
- प्रश्न: सामान्यतः लगभग 5 प्रश्न, प्रायः एक ही डेटा-सेट पर; कोई नेगेटिव मार्किंग नहीं
- पहले पढ़ें: शीर्षक, इकाई और पैमाना; फिर प्रश्न के लिए ज़रूरी आँकड़े
- सूत्र: प्रतिशत परिवर्तन = (नया − पुराना) ÷ पुराना × 100; पाई चार्ट: 1% = 3.6°
- बड़ा जाल: प्रतिशत और प्रतिशत-अंक का अंतर; काटा गया अक्ष
- अभ्यास: रोज़ 2–3 डेटा-सेट: तालिका, दंड, रेखा, पाई
🎯 तारीख़, पैटर्न और नियम
परीक्षा की तारीख़ें, पैटर्न और पूरा सिलेबस हर सत्र में बदल सकते हैं। ताज़ा जानकारी के लिए NTA की सूचना और हमारी UGC NET JRF कैसे क्रैक करें गाइड देखें।
🎯 अद्यतन-सूचना
इस इकाई के कुछ तथ्य (राष्ट्रीय लेखे की नई शृंखला, जनगणना 2027, सर्वेक्षणों के नए दौर) बदलते रहते हैं। यहाँ की जानकारी अक्टूबर 2026 तक उपलब्ध स्रोतों पर आधारित है। परीक्षा के महीने से पहले MoSPI और गृह मंत्रालय की वेबसाइट पर एक बार देख लें।
📌 इस शृंखला के लेख
- UGC NET Paper 1 Notes in Hindi PDF: सिलेबस, पैटर्न और तैयारी की पूरी गाइड
- इकाई 1: Teaching Aptitude Notes in Hindi (शिक्षण अभिवृत्ति)
- इकाई 2: Research Aptitude Notes in Hindi (शोध अभिवृत्ति)
- इकाई 4: Communication Notes in Hindi (संप्रेषण)
- इकाई 7: Data Interpretation Notes in Hindi (यह लेख)
- इकाई 8: ICT Notes in Hindi (सूचना एवं संचार प्रौद्योगिकी)
- इकाई 9: Environment Notes in Hindi (लोग, विकास और पर्यावरण)
- इकाई 10: Higher Education System Notes in Hindi (उच्च शिक्षा प्रणाली)
📑 इस लेख में:
DI क्या है और परीक्षा में कैसे आता है
DI में आपको आँकड़े (तालिका या ग्राफ़) दिए जाते हैं और उन्हें पढ़कर प्रश्नों के उत्तर निकालने होते हैं। गणित कठिन नहीं होता, पर गति और सटीकता चाहिए। UGC NET में यह प्रायः एक डेटा-सेट पर लगभग 5 प्रश्नों के रूप में आता है, इसलिए एक सेट समझ लेने पर पूरे 5 प्रश्न सध जाते हैं।
💡 DI में सफलता के 5 सूत्र
- शीर्षक, इकाई और पैमाना पहले पढ़ें (हज़ार, लाख, प्रतिशत)।
- प्रश्न पढ़कर केवल ज़रूरी आँकड़े देखें।
- प्रतिशत, अनुपात और औसत की मूल गणनाएँ तेज़ करें।
- जहाँ विकल्प दूर-दूर हों वहाँ सन्निकटन (अनुमान) से काम चलाएँ।
- ‘प्रतिशत’ और ‘प्रतिशत-अंक’ का अंतर याद रखें।
आँकड़े: प्रकार और संग्रह
आँकड़े (Data) अवलोकन, मापन या गणना से प्राप्त तथ्य हैं। उन्हें व्यवस्थित करके अर्थ दिया जाए तो वे सूचना बनते हैं, और सूचना से ज्ञान तथा निर्णय। क्रम: आँकड़े → सूचना → ज्ञान → प्रज्ञा।
| आधार | प्रकार | आशय / उदाहरण |
|---|---|---|
| प्रकृति | मात्रात्मक (Quantitative) | संख्यात्मक: आय, आयु, अंक। असतत (संतानों की संख्या) और सतत (ऊँचाई) |
| गुणात्मक (Qualitative) | वर्णनात्मक या श्रेणीगत: लिंग, पसंद, मत | |
| स्रोत | प्राथमिक (Primary) | शोधकर्ता द्वारा सीधे जुटाए: सर्वेक्षण, साक्षात्कार, प्रयोग |
| द्वितीयक (Secondary) | पहले से प्रकाशित: जनगणना, रिपोर्ट, डेटाबेस | |
| समय | समय-श्रृंखला (Time Series) | एक इकाई के आँकड़े अलग-अलग समय पर: वार्षिक GDP |
| अनुप्रस्थ-काट (Cross-section) | एक समय पर अनेक इकाइयाँ: एक वर्ष में सभी राज्यों की साक्षरता | |
| आकार और गति | बिग डेटा (5 V) | Volume, Velocity, Variety, Veracity, Value |
| संग्रह की विधि | विशेषता |
|---|---|
| जनगणना (Census) | सभी इकाइयों से सूचना: सटीक, पर महँगी और समय-साध्य |
| नमूना सर्वेक्षण | प्रतिनिधि प्रतिदर्श: सस्ता और तेज़, पर प्रतिदर्श-त्रुटि संभव |
| प्रशासनिक अभिलेख | सरकारी कामकाज से बने आँकड़े (पंजीकरण, GST, UDISE+) |
| प्रश्नावली, अनुसूची, साक्षात्कार | प्रत्यक्ष संग्रह (CAPI, CATI, ऑनलाइन फ़ॉर्म) |
| अवलोकन और प्रयोग | व्यवहार का प्रत्यक्ष अवलोकन या नियंत्रित प्रयोग |
| रिमोट सेंसिंग, सेंसर, डिजिटल पदचिह्न | उपग्रह, IoT, मोबाइल लोकेशन, वेब-लॉग |
भारत में आँकड़ों के स्रोत
| संस्था / सर्वेक्षण | क्षेत्र |
|---|---|
| जनगणना (RGI, गृह मंत्रालय) | हर 10 वर्ष में; नियमित रूप से 1881 से; स्वतंत्र भारत की पहली 1951; अंतिम पूर्ण जनगणना 2011 |
| NSO (MoSPI) | GDP और राष्ट्रीय लेखे, CPI, IIP, PLFS, घरेलू उपभोग-व्यय सर्वेक्षण, NSS |
| PLFS | बेरोज़गारी दर और श्रम-बल सहभागिता दर |
| NFHS (IIPS मुंबई) | स्वास्थ्य, पोषण, प्रजनन, टीकाकरण; NFHS-5 (2019–21) |
| UDISE+ | विद्यालयी शिक्षा (शिक्षा मंत्रालय) |
| AISHE | उच्च शिक्षा: GER, नामांकन, संस्थान (शिक्षा मंत्रालय) |
| नमूना पंजीकरण प्रणाली (SRS) | जन्म-मृत्यु दर, IMR, TFR (RGI) |
| NCRB | अपराध के आँकड़े: ‘भारत में अपराध’ |
| RBI, आर्थिक सर्वेक्षण, नीति आयोग | मौद्रिक और राजकोषीय आँकड़े, SDG India Index, MPI, राज्य-रैंकिंग |
| CPCB, IMD, ISRO (NRSC) | प्रदूषण, मौसम, उपग्रह-आधारित भू-आँकड़े |
| राष्ट्रीय सांख्यिकी आयोग (NSC) | 2005 में स्थापित; राष्ट्रीय सांख्यिकीय प्रणाली की देखरेख |
🎯 नवीनतम: राष्ट्रीय लेखे और जनगणना
- GDP की नई शृंखला: MoSPI ने 27 फ़रवरी 2026 को आधार-वर्ष 2022-23 पर आधारित नई राष्ट्रीय लेखा-शृंखला जारी की (पुरानी का आधार-वर्ष 2011-12 था)। इसमें GST, eVAHAN आदि प्रशासनिक और उच्च-आवृत्ति स्रोतों का प्रयोग और कुछ क्षेत्रों (कृषि, विनिर्माण) में दोहरा अपस्फीतिकरण (Double Deflation) शामिल है। अन्य सूचकांकों (CPI, IIP) के आधार-वर्ष MoSPI से जाँच लें।
- जनगणना 2027: मकान-सूचीकरण (Houselisting) का चरण अप्रैल से सितंबर 2026 में और जनसंख्या-गणना फ़रवरी–मार्च 2027 में बताई गई है। इसे पहली डिजिटल जनगणना कहा जा रहा है, जिसमें स्व-गणना की सुविधा और जाति-गणना शामिल है। सटीक तिथियाँ गृह मंत्रालय की अधिसूचना से मिलाएँ।
वर्गीकरण और केंद्रीय प्रवृत्ति
| पद | आशय |
|---|---|
| बारंबारता (f) | किसी मान या वर्ग के आने की संख्या |
| वर्ग-अंतराल | जैसे 10–20; वर्ग-आकार (h) = ऊपरी − निचली सीमा |
| वर्ग-चिह्न (x) | (निचली + ऊपरी सीमा) ÷ 2 |
| अपवर्जी वर्ग | ऊपरी सीमा शामिल नहीं: 10–20, 20–30 (20 अगले वर्ग में) |
| समावेशी वर्ग | दोनों सीमाएँ शामिल: 10–19, 20–29 |
| संचयी बारंबारता (cf) | क्रमशः जोड़ी गई बारंबारता: ‘से कम’ और ‘से अधिक’ |
| सापेक्ष बारंबारता | f ÷ N; प्रतिशत = (f ÷ N) × 100 |
| स्टर्जेस नियम | वर्गों की संख्या k ≈ 1 + 3.322 log₁₀ N |
समूहित आँकड़ों का हल-उदाहरण (50 विद्यार्थियों के अंक)
| वर्ग | बारंबारता (f) | वर्ग-चिह्न (x) | f × x | संचयी (cf) |
|---|---|---|---|---|
| 0–10 | 5 | 5 | 25 | 5 |
| 10–20 | 8 | 15 | 120 | 13 |
| 20–30 | 15 | 25 | 375 | 28 |
| 30–40 | 16 | 35 | 560 | 44 |
| 40–50 | 6 | 45 | 270 | 50 |
| योग | N = 50 | 1350 |
| माप | सूत्र | गणना | परिणाम |
|---|---|---|---|
| माध्य | Σfx ÷ N | 1350 ÷ 50 | 27 |
| माध्यिका | L + [(N/2 − cf) ÷ f] × h | वर्ग 20–30; 20 + [(25 − 13) ÷ 15] × 10 | 28 |
| बहुलक | L + [(f₁ − f₀) ÷ (2f₁ − f₀ − f₂)] × h | वर्ग 30–40; 30 + [(16 − 15) ÷ (32 − 15 − 6)] × 10 | ≈ 30.91 |
📌 जाँचने की युक्ति
बहुलक ≈ 3 × माध्यिका − 2 × माध्य = 3 × 28 − 2 × 27 = 30। यह 30.91 के निकट है, इसलिए हल सही लगता है।
आलेखीय निरूपण
| आलेख | उपयुक्त आँकड़े | विशेषता और सावधानी |
|---|---|---|
| दंड-आरेख (Bar Chart) | श्रेणीगत या असतत आँकड़ों की तुलना | दंड अलग-अलग; ऊँचाई ∝ मान। रूप: सरल, बहु, ढेर (stacked) |
| आयतचित्र (Histogram) | सतत आँकड़ों का वितरण | आयत सटे हुए; क्षेत्रफल ∝ बारंबारता |
| बारंबारता बहुभुज | वितरण; कई वितरणों की तुलना | वर्ग-चिह्नों को रेखा से जोड़ना |
| ओजाइव (Ogive) | संचयी बारंबारता | ‘से कम’ और ‘से अधिक’ वक्रों का कटान-बिंदु = माध्यिका |
| वृत्त-चित्र (Pie) | पूर्ण के अंश | कोण = (अंश ÷ कुल) × 360°; 1% = 3.6° |
| रेखा-चित्र (Line) | समय-श्रृंखला, प्रवृत्ति | x-अक्ष पर समय; ढाल = वृद्धि-दर |
| प्रकीर्ण आरेख (Scatter) | दो चरों का संबंध | बिंदुओं की दिशा से धनात्मक/ऋणात्मक सहसंबंध |
| बॉक्स-प्लॉट | वितरण, चतुर्थक, बाह्य मान | न्यूनतम, Q₁, माध्यिका, Q₃, अधिकतम |
| रडार, हीट-मैप, ट्री-मैप | बहु-गुण, घनत्व, पदानुक्रम | रंग या आकार से मान दिखाना |
आँकड़ों का मानचित्रण
| मानचित्र | आशय |
|---|---|
| कोरोप्लेथ | क्षेत्र को मान के अनुसार रंग-छाया (जैसे राज्यवार साक्षरता) |
| बिंदु-मानचित्र | हर बिंदु = निश्चित संख्या |
| सम-मान रेखा (Isopleth) | समान मान जोड़ने वाली रेखाएँ: समताप, समदाब, समोच्च |
| अनुपाती प्रतीक | वृत्त या स्तंभ का आकार मान के अनुपात में |
| GIS | स्थानिक आँकड़ों का संग्रह, विश्लेषण और प्रदर्शन |
⚠️ भ्रामक आलेख पहचानें
- काटा गया अक्ष (Truncated Axis): अंतर बढ़ा-चढ़ाकर दिखता है।
- असमान पैमाने।
- 3-D प्रभाव से मान का भ्रम।
- चुने हुए समय-खंड।
- सहसंबंध को कारण बता देना।
गणना के सूत्र
| अवधारणा | सूत्र | टिप्पणी |
|---|---|---|
| प्रतिशत परिवर्तन | (नया − पुराना) ÷ पुराना × 100 | आधार हमेशा पुराना मान |
| प्रतिशत-अंक परिवर्तन | नया % − पुराना % | दरों के अंतर को ‘अंक’ कहें |
| प्रतिशत हिस्सा | (भाग ÷ कुल) × 100 | पाई चार्ट में |
| औसत | योग ÷ संख्या | |
| अनुपात से हिस्सा | a : b ⇒ a का हिस्सा = a ÷ (a + b) × 100 | |
| CAGR | (अंतिम ÷ प्रारंभिक)^(1/n) − 1 | n = वर्षों का अंतर |
| सूचकांक | (चालू वर्ष का मान ÷ आधार-वर्ष का मान) × 100 | आधार-वर्ष = 100 |
| प्रति-व्यक्ति | कुल ÷ जनसंख्या | आय, खपत आदि |
💡 शीघ्र सन्निकटन
1/8 = 12.5%, 3/8 = 37.5%, 1/6 ≈ 16.7%, 1/7 ≈ 14.3%, 1/9 ≈ 11.1%। भिन्नों की तुलना के लिए क्रॉस-गुणन करें। छोटे आधार पर थोड़ी वृद्धि भी बड़े प्रतिशत की दिखती है।
हल सहित चार डेटा-सेट
नीचे के सभी आँकड़े काल्पनिक हैं और केवल अभ्यास के लिए हैं। पहले ग्राफ़ देखें और प्रश्न खुद हल करें, फिर तालिका से मिलाएँ।
सेट 1: दंड-आरेख (बहु-दंड)
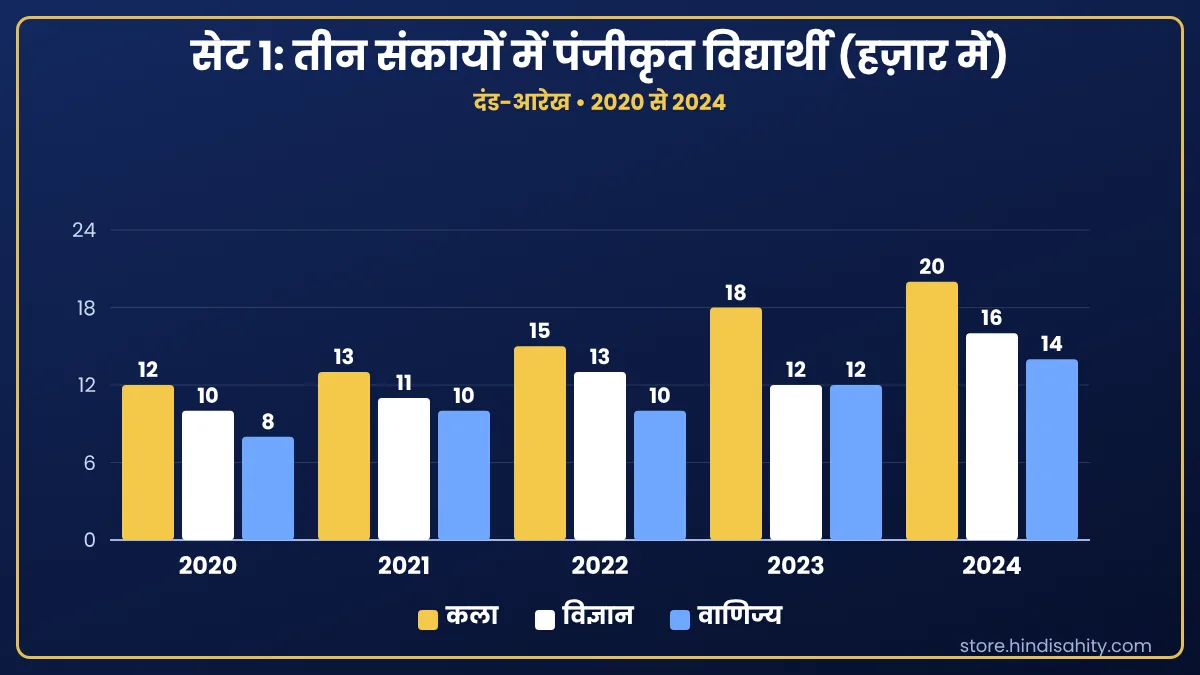
| प्रश्न | हल | उत्तर |
|---|---|---|
| 2022 में कुल पंजीकृत विद्यार्थी? | 15 + 13 + 10 | 38 हज़ार |
| 2020 से 2024 तक कला संकाय में प्रतिशत वृद्धि? | (20 − 12) ÷ 12 × 100 | 66.67% |
| 2022 में विज्ञान : वाणिज्य का अनुपात? | 13 : 10 | 13 : 10 |
| किस वर्ष कुल में सर्वाधिक वार्षिक वृद्धि? | कुल: 30, 34, 38, 42, 50; वृद्धि 4, 4, 4, 8 | 2024 |
| पाँच वर्षों में विज्ञान का औसत? | (10 + 11 + 13 + 12 + 16) ÷ 5 | 12.4 हज़ार |
सेट 2: रेखा-चित्र
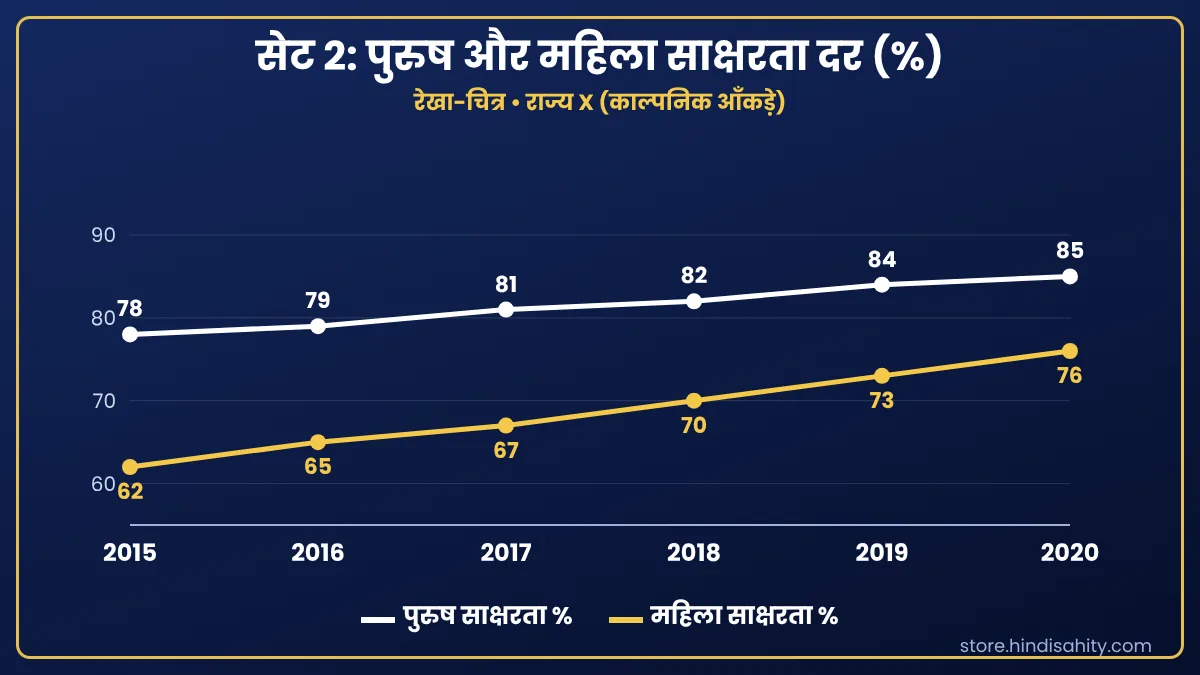
| प्रश्न | हल | उत्तर |
|---|---|---|
| 2015 और 2020 में लैंगिक अंतर, और कितना घटा? | 78 − 62 = 16; 85 − 76 = 9; घटाव 7 | 16 और 9; 7 प्रतिशत-अंक |
| महिला साक्षरता में 2015 से 2020 की वृद्धि? | 76 − 62 = 14; 14 ÷ 62 × 100 | 14 प्रतिशत-अंक; लगभग 22.58% |
| किस वर्ष लैंगिक अंतर न्यूनतम? | अंतर: 16, 14, 14, 12, 11, 9 | 2020 |
| पुरुष साक्षरता का 6 वर्ष का औसत? | (78 + 79 + 81 + 82 + 84 + 85) ÷ 6 = 489 ÷ 6 | 81.5% |
सेट 3: वृत्त-चित्र
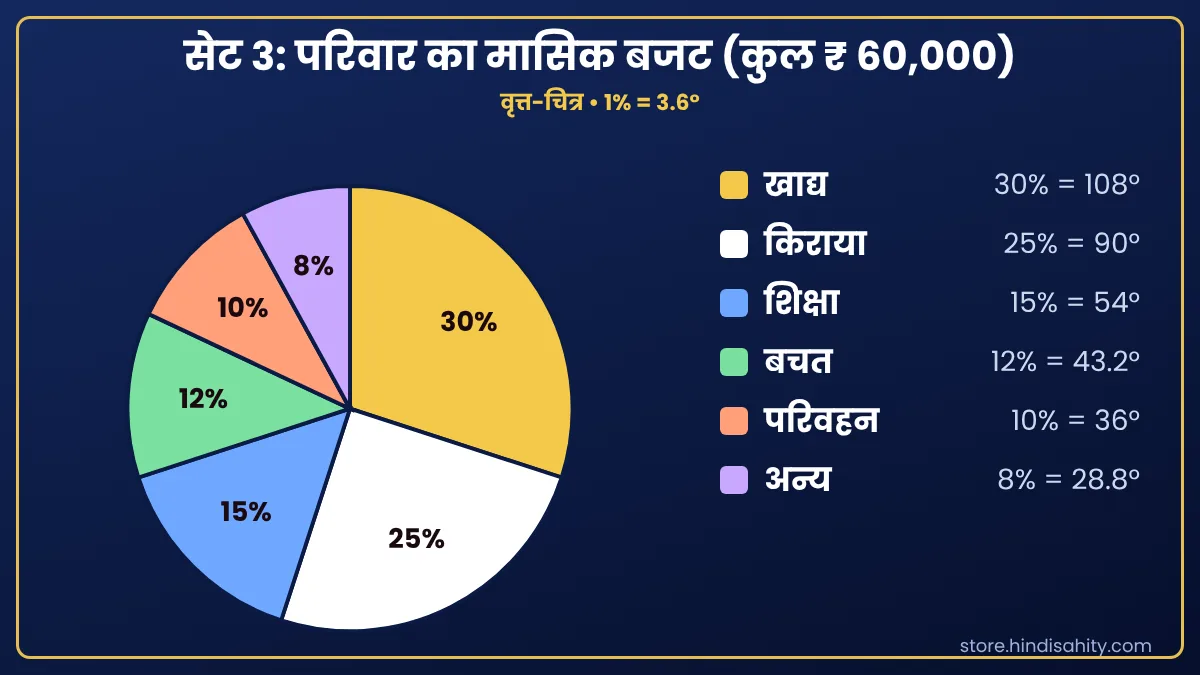
| प्रश्न | हल | उत्तर |
|---|---|---|
| शिक्षा पर व्यय? | 15% × 60,000 | ₹ 9,000 |
| बचत और परिवहन के व्यय में अंतर? | (12 − 10)% × 60,000 | ₹ 1,200 |
| किराये के क्षेत्र का केंद्रीय कोण? | 25 × 3.6° | 90° |
| खाद्य : शिक्षा का अनुपात? | 30 : 15 | 2 : 1 |
सेट 4: तालिका
| महाविद्यालय | परीक्षा में बैठे | उत्तीर्ण | उत्तीर्ण % |
|---|---|---|---|
| A | 400 | 340 | 85% |
| B | 500 | 375 | 75% |
| C | 300 | 276 | 92% |
| D | 250 | 175 | 70% |
| योग | 1450 | 1166 | ≈ 80.41% |
| प्रश्न | हल | उत्तर |
|---|---|---|
| सर्वाधिक उत्तीर्ण-प्रतिशत किसका? | 276 ÷ 300 = 92% | महाविद्यालय C |
| चारों का संयुक्त उत्तीर्ण प्रतिशत? | 1166 ÷ 1450 × 100 | ≈ 80.41% |
| B और D में मिलाकर अनुत्तीर्ण संख्या? | (500 − 375) + (250 − 175) = 125 + 75 | 200 |
⚠️ सबसे आम जाल
संयुक्त प्रतिशत निकालते समय चारों प्रतिशतों का औसत (85 + 75 + 92 + 70) ÷ 4 = 80.5% लेना ग़लत है। सही तरीक़ा है कुल उत्तीर्ण ÷ कुल बैठे = 80.41%। दोनों में थोड़ा अंतर आता है, और विकल्प पास-पास हों तो यही फ़र्क़ निर्णायक होता है।
गुणात्मक आँकड़ों का विश्लेषण
| पद | आशय |
|---|---|
| कोडिंग | पाठ्य-आँकड़ों में विचार या विषय को लेबल देना |
| थीम-विश्लेषण | कोडों को समूहित कर आवर्ती विषय निकालना (ब्राउन और क्लार्क) |
| सामग्री-विश्लेषण | पाठ में शब्दों या विषयों की बारंबारता की गणना और व्याख्या |
| विमर्श-विश्लेषण | भाषा-प्रयोग में शक्ति-संबंधों का अध्ययन |
| विश्वसनीयता के मानदंड (लिंकन–गुबा) | विश्वसनीयता, हस्तांतरणीयता, निर्भरता, पुष्टि-योग्यता |
| सॉफ़्टवेयर | NVivo, Atlas.ti, MAXQDA |
| पक्ष | मात्रात्मक | गुणात्मक |
|---|---|---|
| उद्देश्य | कितना या कितने: मापन और परीक्षण | क्यों या कैसे: अर्थ और संदर्भ की समझ |
| प्रस्तुति | सारणी, आलेख, सांख्यिकी | थीम, वर्णन, उद्धरण |
| सावधानी | भ्रामक आलेख, प्रतिदर्श-त्रुटि | शोधकर्ता-पक्षपात, संदर्भ-विशिष्टता |
आँकड़े और शासन
आँकड़ा-आधारित शासन का अर्थ है सार्वजनिक नीतियों, सेवाओं और निगरानी में साक्ष्य का प्रयोग। इससे पारदर्शिता, दक्षता और लक्षित लाभ-वितरण बेहतर होता है। क्रम: आँकड़ा-संग्रह → विश्लेषण → नीति-निर्माण → क्रियान्वयन → निगरानी और मूल्यांकन।
| पहल / अवधारणा | विवरण |
|---|---|
| NDSAP, 2012 | सरकारी आँकड़ों को खुले रूप में साझा करने की नीति; खुला पोर्टल data.gov.in |
| NDAP (नीति आयोग) | विभिन्न मंत्रालयों के आँकड़ों का एकीकृत, विश्लेषण-योग्य मंच |
| आधार (UIDAI) | 12-अंकीय अद्वितीय पहचान; आधार अधिनियम, 2016; DBT में सत्यापन |
| JAM त्रयी | जन-धन खाते, आधार और मोबाइल: सब्सिडी के लक्षित अंतरण का आधार |
| इंडिया स्टैक / DPI | डिजिटल सार्वजनिक अवसंरचना: आधार, e-KYC, UPI, DigiLocker, Account Aggregator |
| SDG इंडिया इंडेक्स, MPI | नीति आयोग की राज्य-रैंकिंग और बहुआयामी गरीबी सूचकांक; 2023 की रिपोर्ट के अनुसार MPI 2015-16 के 24.85% से घटकर 2019-21 में 14.96% |
| डेटा गुणवत्ता के आयाम | शुद्धता, पूर्णता, समयबद्धता, संगति, वैधता, विशिष्टता |
| डेटा नैतिकता और निजता | सहमति, उद्देश्य-सीमा, डेटा-न्यूनता; डिजिटल व्यक्तिगत डेटा संरक्षण (DPDP) अधिनियम, 2023 |
| सूचक | आशय |
|---|---|
| GDP / GNP / NNP | देश की सीमा में / राष्ट्रीय स्वामित्व वाले कारकों से / मूल्यह्रास घटाकर उत्पादन का मूल्य |
| CPI / WPI | उपभोक्ता मूल्य सूचकांक (खुदरा) / थोक मूल्य सूचकांक |
| जिनी गुणांक | असमानता का माप: 0 = पूर्ण समानता, 1 = पूर्ण असमानता; लॉरेंज वक्र से |
| GER | किसी स्तर का कुल नामांकन ÷ उस स्तर की आयु-वर्ग की जनसंख्या × 100 |
| IMR / MMR / TFR | शिशु मृत्यु दर (प्रति 1000 जीवित जन्म) / मातृ मृत्यु अनुपात (प्रति 1 लाख) / कुल प्रजनन दर |
त्वरित पुनरावृत्ति और परीक्षा के जाल
| विषय | तुरंत याद रखें |
|---|---|
| आँकड़े | आँकड़े → सूचना → ज्ञान → प्रज्ञा; प्राथमिक बनाम द्वितीयक |
| आलेख | आयतचित्र: सटे आयत, सतत आँकड़े; दंड-आरेख: अलग दंड |
| गणना | प्रतिशत परिवर्तन का आधार पुराना मान; 1% = 3.6° |
| सूचकांक | आधार-वर्ष = 100 |
| स्रोत | PLFS (श्रम), NFHS (स्वास्थ्य), UDISE+ (स्कूल), AISHE (उच्च शिक्षा), NCRB (अपराध) |
| खुला डेटा | NDSAP 2012, data.gov.in |
⚠️ परीक्षा के आम जाल
- प्रतिशत और प्रतिशत-अंक को मिला देना।
- प्रतिशतों का औसत लेकर संयुक्त प्रतिशत निकालना।
- इकाई (हज़ार या लाख) को अनदेखा करना।
- आयतचित्र और दंड-आरेख को एक मान लेना।
- काटे गए अक्ष वाले ग्राफ़ को सही मान लेना।
💡 समय-प्रबंधन का सुझाव
एक सेट के लिए पहले शीर्षक और पैमाना, फिर प्रश्न। पहली बार में कठिन लगने वाला प्रश्न छोड़कर आगे बढ़ें और अंत में लौटें। गति अभ्यास से आती है, इसलिए रोज़ 2–3 सेट हल करें।
Data Interpretation MCQ in Hindi (UGC NET पैटर्न, उत्तर और व्याख्या सहित)
पहले 8 प्रश्न दो डेटा-सेट पर हैं, फिर बहु-कथन, कथन I-कथन II, अभिकथन-कारण, सुमेलित और क्रम वाले प्रश्न, जैसे UGC NET में आते हैं। पहले उत्तर सोचें, फिर “उत्तर देखें” पर क्लिक करें।
📊 डेटा-सेट A (प्रश्न 1 से 5): एक विश्वविद्यालय में स्नातकोत्तर नामांकन (हज़ार में)
| विषय | 2021 | 2022 | 2023 | 2024 |
|---|---|---|---|---|
| हिंदी | 20 | 24 | 30 | 36 |
| अंग्रेज़ी | 15 | 18 | 21 | 27 |
| इतिहास | 10 | 12 | 15 | 18 |
काल्पनिक आँकड़े, केवल अभ्यास के लिए।
प्रश्न 1. डेटा-सेट A के अनुसार 2023 में कुल नामांकन (हज़ार में) कितना है?
- (क) 60
- (ख) 64
- (ग) 66
- (घ) 70
👉 उत्तर देखें
✅ उत्तर: (ग) 66. 30 + 21 + 15 = 66 हज़ार।
प्रश्न 2. 2021 से 2024 तक हिंदी विषय के नामांकन में प्रतिशत वृद्धि कितनी है?
- (क) 60%
- (ख) 70%
- (ग) 80%
- (घ) 90%
👉 उत्तर देखें
✅ उत्तर: (ग) 80%. (36 − 20) ÷ 20 × 100 = 80%। प्रतिशत-वृद्धि में आधार हमेशा पुराना मान होता है।
प्रश्न 3. 2024 में कुल नामांकन में हिंदी का हिस्सा (लगभग) कितना है?
- (क) 40%
- (ख) 44.4%
- (ग) 50%
- (घ) 55.5%
👉 उत्तर देखें
✅ उत्तर: (ख) 44.4%. 2024 का कुल = 36 + 27 + 18 = 81; 36 ÷ 81 × 100 ≈ 44.4%।
प्रश्न 4. किस वर्ष कुल नामांकन में पिछले वर्ष की तुलना में सबसे अधिक अंकीय वृद्धि हुई?
- (क) 2022
- (ख) 2023
- (ग) 2024
- (घ) तीनों वर्षों में समान
👉 उत्तर देखें
✅ उत्तर: (ग) 2024. कुल: 45, 54, 66, 81। वृद्धि: 9, 12, 15। सबसे अधिक वृद्धि 2024 में (15)।
प्रश्न 5. 2022 में अंग्रेज़ी और इतिहास के नामांकन का अनुपात क्या है?
- (क) 2 : 3
- (ख) 3 : 2
- (ग) 4 : 3
- (घ) 5 : 4
👉 उत्तर देखें
✅ उत्तर: (ख) 3 : 2. अंग्रेज़ी 18 और इतिहास 12, यानी 18 : 12 = 3 : 2।
📊 डेटा-सेट B (प्रश्न 6 से 8): एक विद्यालय का वार्षिक बजट ₹ 50 लाख, व्यय का वितरण
| मद | वेतन | भवन | पुस्तकालय | खेल | अन्य |
|---|---|---|---|---|---|
| व्यय % | 50 | 20 | 10 | 8 | 12 |
काल्पनिक आँकड़े, केवल अभ्यास के लिए।
प्रश्न 6. डेटा-सेट B के अनुसार भवन पर व्यय (₹ लाख में) कितना है?
- (क) 8
- (ख) 10
- (ग) 12
- (घ) 15
👉 उत्तर देखें
✅ उत्तर: (ख) 10. कुल बजट ₹ 50 लाख का 20% = ₹ 10 लाख।
प्रश्न 7. वृत्त-चित्र में वेतन के क्षेत्र का केंद्रीय कोण कितना होगा?
- (क) 90°
- (ख) 150°
- (ग) 180°
- (घ) 200°
👉 उत्तर देखें
✅ उत्तर: (ग) 180°. 50 × 3.6° = 180°। 1% के लिए 3.6° होता है।
प्रश्न 8. पुस्तकालय और खेल पर कुल व्यय (₹ लाख में) कितना है?
- (क) 7.5
- (ख) 8
- (ग) 9
- (घ) 10
👉 उत्तर देखें
✅ उत्तर: (ग) 9. (10 + 8)% = 18%; 18% × 50 = ₹ 9 लाख।
प्रश्न 9. आयतचित्र (Histogram) के बारे में निम्नलिखित कथनों पर विचार कीजिए:
(A) इसके आयत एक-दूसरे से सटे होते हैं।
(B) यह सतत आँकड़ों के बारंबारता-वितरण के लिए प्रयुक्त होता है।
(C) आयत का क्षेत्रफल बारंबारता के अनुपाती होता है।
(D) यह श्रेणीगत आँकड़ों की तुलना के लिए सर्वोत्तम है।
- (क) केवल (A), (B) और (C)
- (ख) केवल (A), (B) और (D)
- (ग) केवल (B), (C) और (D)
- (घ) (A), (B), (C) और (D) सभी
👉 उत्तर देखें
✅ उत्तर: (क) केवल (A), (B) और (C). (A), (B) और (C) सही हैं। (D) गलत है: श्रेणीगत आँकड़ों की तुलना दंड-आरेख से होती है, जिसमें दंड अलग-अलग रहते हैं।
प्रश्न 10. बेरोज़गारी दर 8% से घटकर 6% हो गई। यह कमी है:
- (क) 2% (प्रतिशत)
- (ख) 2 प्रतिशत-अंक और 25% सापेक्ष कमी
- (ग) 25 प्रतिशत-अंक
- (घ) 2 प्रतिशत-अंक और 33% सापेक्ष कमी
👉 उत्तर देखें
✅ उत्तर: (ख) 2 प्रतिशत-अंक और 25% सापेक्ष कमी. 8 − 6 = 2 प्रतिशत-अंक। सापेक्ष कमी = 2 ÷ 8 × 100 = 25%। आधार पुराना मान (8) है, इसलिए 33% गलत है।
प्रश्न 11. कथन I: जनगणना में लक्षित सभी इकाइयों से सूचना ली जाती है। कथन II: नमूना सर्वेक्षण में प्रतिदर्श-त्रुटि की संभावना नहीं रहती।
- (क) कथन I और II दोनों सही हैं
- (ख) कथन I सही, कथन II गलत है
- (ग) कथन I गलत, कथन II सही है
- (घ) कथन I और II दोनों गलत हैं
👉 उत्तर देखें
✅ उत्तर: (ख) कथन I सही, कथन II गलत है. कथन I सही है। कथन II गलत है: नमूना सर्वेक्षण में केवल प्रतिनिधि प्रतिदर्श लिया जाता है, इसलिए प्रतिदर्श-त्रुटि संभव रहती है। उसका लाभ कम लागत और कम समय है।
प्रश्न 12. अभिकथन (A): काटे गए अक्ष (Truncated Axis) वाला दंड-आरेख भ्रामक हो सकता है। कारण (R): इसमें दंडों के छोटे अंतर भी बहुत बड़े दिखने लगते हैं।
- (क) A और R दोनों सही हैं और R, A की सही व्याख्या है
- (ख) A और R दोनों सही हैं, पर R, A की सही व्याख्या नहीं है
- (ग) A सही है, पर R गलत है
- (घ) A गलत है, पर R सही है
👉 उत्तर देखें
✅ उत्तर: (क) A और R दोनों सही हैं और R, A की सही व्याख्या है. अक्ष शून्य से शुरू न हो तो दंडों की ऊँचाई का अनुपात वास्तविक अनुपात से अलग दिखता है, इसीलिए ग्राफ़ भ्रामक बन जाता है।
प्रश्न 13. सूची I (संस्था/सर्वेक्षण) को सूची II (मुख्य क्षेत्र) से सुमेलित कीजिए:
| सूची I | सूची II |
|---|---|
| (A) PLFS | (I) विद्यालयी शिक्षा के आँकड़े |
| (B) NFHS | (II) श्रम-बल और बेरोज़गारी |
| (C) UDISE+ | (III) स्वास्थ्य, पोषण और प्रजनन |
| (D) NCRB | (IV) अपराध के आँकड़े |
- (क) A-II, B-III, C-I, D-IV
- (ख) A-III, B-II, C-I, D-IV
- (ग) A-II, B-III, C-IV, D-I
- (घ) A-I, B-II, C-III, D-IV
👉 उत्तर देखें
✅ उत्तर: (क) A-II, B-III, C-I, D-IV. PLFS = श्रम-बल (II); NFHS = स्वास्थ्य (III); UDISE+ = विद्यालयी शिक्षा (I); NCRB = अपराध (IV)।
प्रश्न 14. निम्नलिखित को आँकड़ों से प्रज्ञा तक के सही क्रम में रखिए: (A) सूचना (B) आँकड़े (C) ज्ञान (D) प्रज्ञा/निर्णय
- (क) B, A, C, D
- (ख) A, B, C, D
- (ग) B, C, A, D
- (घ) A, C, B, D
👉 उत्तर देखें
✅ उत्तर: (क) B, A, C, D. आँकड़े (Data) → सूचना (Information) → ज्ञान (Knowledge) → प्रज्ञा/निर्णय (Wisdom)।
प्रश्न 15. राष्ट्रीय डेटा साझाकरण एवं अभिगम्यता नीति (NDSAP) 2012 के अंतर्गत सरकारी आँकड़े किस खुले पोर्टल पर साझा किए जाते हैं?
- (क) data.gov.in
- (ख) uidai.gov.in
- (ग) niti.gov.in
- (घ) mospi.gov.in
👉 उत्तर देखें
✅ उत्तर: (क) data.gov.in. खुला सरकारी डेटा प्लेटफ़ॉर्म data.gov.in है। NDAP (नीति आयोग) अलग मंच है, जो मंत्रालयों के आँकड़ों को विश्लेषण-योग्य रूप में जोड़ता है।
प्रश्न 16. किसी वस्तु का आधार-वर्ष का मान 200 और चालू वर्ष का मान 250 है। चालू वर्ष का सूचकांक (आधार-वर्ष = 100) क्या होगा?
- (क) 80
- (ख) 120
- (ग) 125
- (घ) 150
👉 उत्तर देखें
✅ उत्तर: (ग) 125. सूचकांक = (चालू मान ÷ आधार मान) × 100 = (250 ÷ 200) × 100 = 125।
📄 नोट्स कैसे हैं? पहले मुफ़्त नमूना देखें
ई-बुक की इकाई 1 (शिक्षण अभिवृत्ति) पूरी मुफ़्त है: 30 पन्ने, 40 अभ्यास प्रश्न। इसी ढाँचे में DI के नोट्स ई-बुक में हैं।
DI की तैयारी कैसे करें? (5 दिन की योजना)
| दिन | क्या करें |
|---|---|
| दिन 1 | आँकड़ों के प्रकार और स्रोत; प्रतिशत, अनुपात और औसत की मूल गणनाएँ |
| दिन 2 | तालिका वाले 3–4 सेट हल करें; प्रतिशत परिवर्तन बनाम प्रतिशत-अंक |
| दिन 3 | दंड-आरेख और रेखा-चित्र के सेट; वृद्धि-दर और औसत |
| दिन 4 | पाई चार्ट (कोण, हिस्सा) और सूचकांक; आँकड़े और शासन का रिवीज़न |
| दिन 5 | 16 MCQ दोबारा हल करें, गलत प्रश्नों की सूची बनाएँ और 3–4 नए सेट समय-सीमा में हल करें |
- हर सेट में पहले शीर्षक, इकाई और पैमाना पढ़ें।
- प्रश्न के लिए सिर्फ़ ज़रूरी आँकड़े देखें, पूरी तालिका का हिसाब न लगाएँ।
- विकल्प दूर हों तो अनुमान से काम चलाएँ।
- पिछली इकाइयाँ: Teaching Aptitude, Research Aptitude, Communication, ICT, Environment और Higher Education System।
- पूरी Paper 1 की योजना: UGC NET JRF कैसे क्रैक करें।
- वीडियो से पढ़ना हो तो हिंदी साहित्य चैनल (YouTube) देखें।
UGC NET Paper 1 Notes in Hindi: पूरी ई-बुक
DI के विस्तृत नोट्स, पूरी तालिकाएँ, माइंड मैप और अभ्यास प्रश्न सभी 10 इकाइयों की ई-बुक (247 पन्ने, Hindi Medium) में हैं।
📘 UGC NET Paper 1 Notes in Hindi: पूरी ई-बुक
247 पन्ने • सभी 10 इकाइयाँ • Hindi Medium • तालिकाएँ, माइंड मैप और अभ्यास प्रश्न
कोई सवाल हो तो WhatsApp पर संपर्क करें।
Data Interpretation से जुड़े अक्सर पूछे जाने वाले प्रश्न (FAQ)
❓ UGC NET Paper 1 में Data Interpretation से कितने प्रश्न आते हैं?
यह Paper 1 की इकाई 7 है। सामान्यतः इससे लगभग 5 प्रश्न आते हैं, जो प्रायः एक ही डेटा-सेट (तालिका या ग्राफ़) पर होते हैं। प्रश्नों की संख्या के लिए NTA की ताज़ा सूचना देखें। कोई नेगेटिव मार्किंग नहीं है।
❓ Data Interpretation (DI) क्या है?
तालिका, दंड-आरेख, रेखा-चित्र, वृत्त-चित्र आदि के रूप में दिए आँकड़ों को पढ़कर उनसे प्रतिशत, अनुपात, औसत और वृद्धि जैसी गणनाएँ करने और निष्कर्ष निकालने को आँकड़ा निर्वचन कहते हैं।
❓ DI की तैयारी कैसे करें?
पहले प्रतिशत, अनुपात और औसत की मूल गणनाएँ तेज़ करें। फिर चारों प्रकार के सेट (तालिका, दंड, रेखा, पाई) रोज़ 2–3 हल करें। हर सेट में पहले शीर्षक, इकाई और पैमाना पढ़ें।
❓ प्रतिशत और प्रतिशत-अंक में क्या अंतर है?
जब किसी दर को दूसरी दर से घटाया जाता है तो अंतर प्रतिशत-अंक में कहा जाता है। जैसे 60% से 75% होने पर वृद्धि 15 प्रतिशत-अंक है, जबकि सापेक्ष वृद्धि 25% है।
❓ पाई चार्ट में केंद्रीय कोण कैसे निकालते हैं?
कोण = (अंश ÷ कुल) × 360°। प्रतिशत में दिया हो तो 1% = 3.6°। जैसे 25% का कोण 90° होगा।
❓ आयतचित्र (Histogram) और दंड-आरेख (Bar Chart) में क्या अंतर है?
आयतचित्र सतत आँकड़ों के वितरण के लिए है और उसके आयत सटे होते हैं। दंड-आरेख श्रेणीगत या असतत आँकड़ों की तुलना के लिए है और उसके दंडों के बीच अंतर रहता है।
❓ आँकड़ों के प्राथमिक और द्वितीयक स्रोत क्या हैं?
प्राथमिक आँकड़े शोधकर्ता स्वयं सीधे जुटाता है (सर्वेक्षण, साक्षात्कार, प्रयोग)। द्वितीयक आँकड़े पहले से प्रकाशित होते हैं (जनगणना, सरकारी रिपोर्ट, डेटाबेस)।
❓ जनगणना और नमूना सर्वेक्षण में क्या अंतर है?
जनगणना में सभी इकाइयों से सूचना ली जाती है, जो सटीक पर महँगी और समय-साध्य है। नमूना सर्वेक्षण में चुने हुए प्रतिनिधि प्रतिदर्श से सूचना ली जाती है, जो सस्ता और तेज़ है पर उसमें प्रतिदर्श-त्रुटि संभव है।
❓ भ्रामक ग्राफ़ कैसे पहचानें?
काटे गए अक्ष (truncated axis), असमान पैमाने, 3-D प्रभाव, चुने हुए समय-खंड और सहसंबंध को कारण बताने से ग्राफ़ भ्रामक हो सकते हैं। निर्वचन में अक्ष का आरंभ-बिंदु और पैमाना ज़रूर देखें।
❓ आँकड़े और शासन से क्या पूछा जाता है?
आँकड़ों के सरकारी स्रोत (जनगणना, NSO, NFHS, UDISE+, AISHE), खुला डेटा (NDSAP 2012, data.gov.in), आधार और DBT, डिजिटल सार्वजनिक अवसंरचना और डेटा की निजता जैसे विषय आते हैं।
❓ क्या DI में कैलकुलेटर मिलता है?
परीक्षा में कैलकुलेटर की अनुमति के बारे में NTA की सूचना देखें। तैयारी में बिना कैलकुलेटर के सन्निकटन और छोटे हिसाब का अभ्यास करना सबसे उपयोगी रहता है।
❓ DI के हिंदी नोट्स PDF कहाँ मिलेंगे?
सभी 10 इकाइयों के हिंदी नोट्स हिंदी साहित्य चैनल की UGC NET Paper 1 ई-बुक (247 पन्ने) में हैं, और इकाई 1 का मुफ़्त नमूना PDF इस लेख में दिया गया है।
निष्कर्ष
DI में अंक गति, सटीकता और जालों की पहचान से मिलते हैं: शीर्षक और पैमाना पहले पढ़ें, प्रतिशत और प्रतिशत-अंक को अलग रखें, और रोज़ कुछ सेट हल करें। स्रोत, आलेख और आँकड़े-और-शासन वाले हिस्से तालिकाओं से दोहराएँ और नवीनतम तथ्य आधिकारिक वेबसाइट से जाँचें।
📚 यह भी पढ़ें
- UGC NET Paper 1 Notes in Hindi PDF: पूरी गाइड
- UGC NET JRF कैसे क्रैक करें
- इकाई 1: UGC NET Teaching Aptitude Notes in Hindi
- इकाई 2: UGC NET Research Aptitude Notes in Hindi
- इकाई 4: UGC NET Communication Notes in Hindi
- इकाई 8: UGC NET ICT Notes in Hindi
- इकाई 9: UGC NET Environment Notes in Hindi
- इकाई 10: UGC NET Higher Education System Notes in Hindi
- UGC NET Paper 1 Notes in Hindi: पूरी ई-बुक
✍️ लेखक परिचय
केवल कृष्ण घोड़ेला
एम.ए., बी.एड. (नेट हिंदी), कॉलेज व्याख्याता, श्रीगंगानगर (राजस्थान)
हिंदी साहित्य चैनल के संचालक। UGC NET, RPSC और हिंदी साहित्य की परीक्षाओं की तैयारी करने वाले विद्यार्थियों का लंबे समय से मार्गदर्शन कर रहे हैं। इस लेख की जानकारी NTA के पाठ्यक्रम, सरकारी स्रोतों और मानक पुस्तकों के आधार पर तैयार की गई है।
स्रोत: NTA UGC NET, MoSPI, भारत की जनगणना, data.gov.in, नीति आयोग और मानक पुस्तकें। सर्वेक्षण, आधार-वर्ष और आँकड़े बदलते रहते हैं, अंतिम जानकारी के लिए आधिकारिक स्रोत देखें।